 Nico Küchler
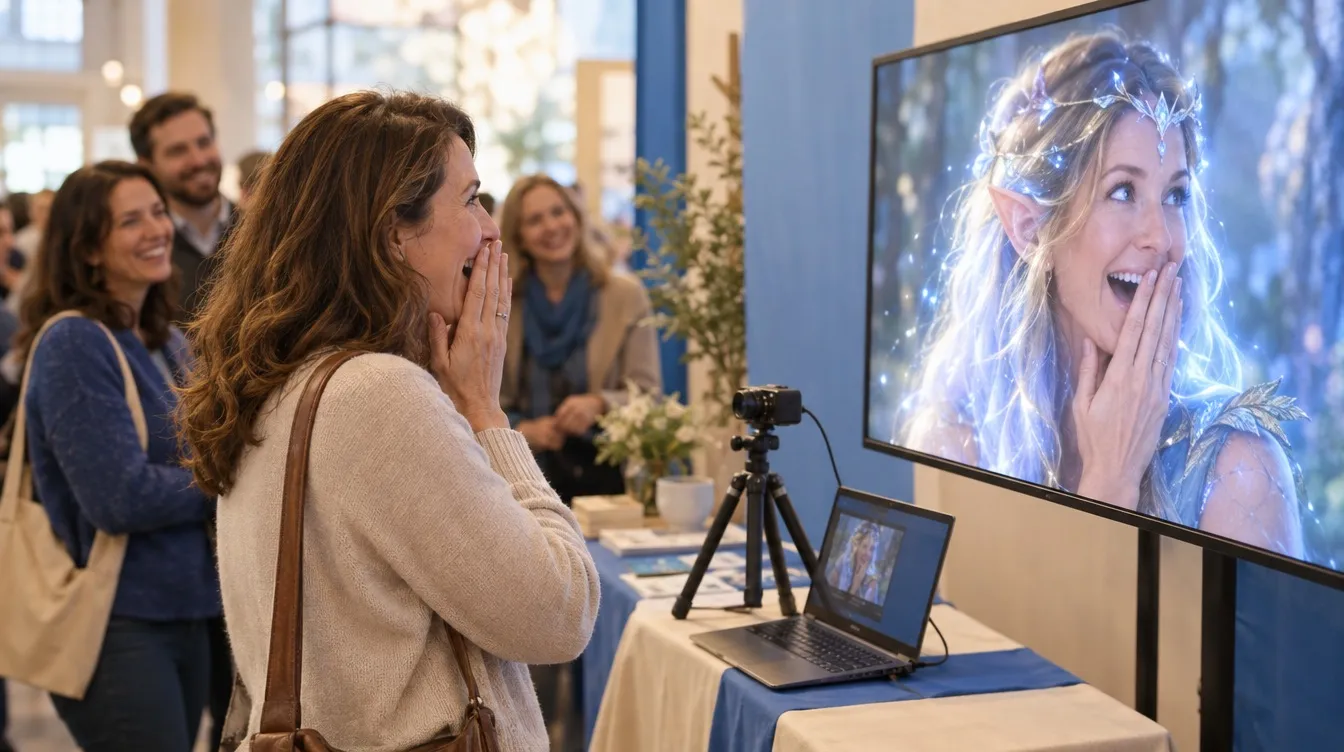
Sie haben sich vor eine Kamera gestellt. Auf dem Bildschirm stand nicht Ihr Spiegelbild, sondern eine Fantasy- oder Manga-Figur. Sie hat gelächelt, als Sie gelächelt haben, und den Kopf gedreht, als Sie ihn gedreht haben. Und als Sie gesprochen haben, kam eine fremde Stimme heraus – mit Ihren Worten.
Das war kein Video, das vorher jemand gebaut hat. Es ist in dem Moment entstanden, in dem Sie davorstanden.
Was da passiert ist
Zwei Programme haben gleichzeitig gearbeitet:
- Das Bild: Das Programm erkennt in jedem Kamerabild Ihr Gesicht und Ihre Haltung – wo die Augen sind, wie weit der Mund offen ist, wohin der Kopf zeigt. Daraus erzeugt es die Figur neu, viele Male pro Sekunde.
- Die Stimme: Ein zweites Programm nimmt Ihre Sprache auf und verändert Klangfarbe und Tonhöhe. Was Sie sagen und wie Sie betonen, bleibt Ihres. Nur die Stimme gehört jemand anderem.
Kein Filmstudio, sondern ein normaler Rechner
Die Station läuft auf einem Computer mit einer Spiele-Grafikkarte, wie man ihn im Elektronikmarkt kaufen kann. Kein Rechenzentrum, keine Internetverbindung.
Einfachere Varianten davon laufen sogar auf dem Handy. Die Gesichtsfilter in Snapchat etwa rechnen ihre KI-Modelle direkt auf dem Gerät, damit sie in Echtzeit mitlaufen. Stimmverzerrer sind in verbreiteten Video-Apps eingebaut. Was Sie an der Station gesehen haben, ist also keine Zukunftstechnik. Es ist die etwas bessere Version von etwas, das Ihre Kinder vermutlich schon benutzen.
Warum wir Ihnen das zeigen
Wer sich selbst als jemand anderen gesehen und gehört hat, muss nicht mehr überzeugt werden, dass so etwas geht. Und was Sie können, können andere auch: sich in einem Videochat als jemand ausgeben, der sie nicht sind, oder mit einer fremden Stimme eine Sprachnachricht schicken.
Wie viel Material dafür nötig ist, hängt vom Aufwand ab. Ein Forschungsprototyp von Microsoft hat schon 2023 eine Stimme aus einer Aufnahme von drei Sekunden nachgeahmt. Ein verbreiteter kommerzieller Dienst empfiehlt ein bis zwei Minuten klare Aufnahme. Für überzeugende Fälschungen in Echtzeit nennt das Bundesamt für Sicherheit in der Informationstechnik (BSI) deutlich mehr: einige Minuten Video oder Ton. Das klingt nach viel – bis man überlegt, wie viele Sprachnachrichten, Videos und Storys es von einem Menschen gibt.
Wie man sich davor schützt, steht im nächsten Artikel: „Wer da wirklich schreibt“.
Unsere Zusage an der Station
Lokal verarbeitet. Kamerabild und Stimme werden nur auf dem Rechner am Stand umgewandelt. Nichts verlässt diesen Rechner.
Nichts gespeichert. Es gibt keine Aufnahme, kein Foto, keine Tonspur. Wenn Sie aus dem Bild gehen, ist nichts mehr da.
Keine Cloud. Die Station ist nicht mit dem Internet verbunden. Kein Anbieter bekommt Ihr Gesicht oder Ihre Stimme zu sehen.
Wir haben die Station bewusst so gebaut. Wer Eltern vor dem sorglosen Umgang mit Bildern und Stimmen warnt, darf selbst nicht damit sorglos umgehen.
Was Sie tun können
- Probieren Sie mit Ihrem Kind einen Gesichts- oder Stimmfilter aus, den es schon kennt, und sprechen Sie darüber, wie echt das wirkt.
- Überlegen Sie gemeinsam, wie viele Videos und Sprachnachrichten von Ihnen und Ihrem Kind öffentlich sichtbar sind.
- Merken Sie sich den Satz: Ein bekanntes Gesicht und eine bekannte Stimme beweisen nicht mehr, wer wirklich dahintersteckt.
Fürs Gespräch mit Ihrem Kind
- „Würdest du merken, wenn in einem Videocall jemand anderes hinter dem Gesicht steckt?“
- „Wem würdest du eine Sprachnachricht von mir glauben – und wann nicht?“
- „Was wäre, wenn jemand mit deiner Stimme etwas sagt, das du nie gesagt hast?“